เปิดลงทะเบียนแล้ว Siam Inference Thailand · 3 ธ.ค. 2026

ชุมชนคนทำ AI Inference ในประเทศไทย ที่ใหญ่ที่สุด

พื้นที่แลกเปลี่ยนความรู้เรื่องการรันโมเดล AI ให้เร็ว คุ้มค่า และใช้งานได้จริง ตั้งแต่ Hardware, Engine ไปจนถึง Application
ตราสัญลักษณ์ Siam Inference: ตัวอักษร S และ i สีเขียว มียอดปราสาทอยู่ตรงกลาง วางบนแท่นสี่เหลี่ยมสองชั้น

AI Inference คืออะไร และทำไมต้องมีชุมชน

AI Inference (การอนุมาน) คือช่วงที่นำโมเดล AI ที่ผ่านการ training แล้วมาใช้งานจริง ทุกคำตอบจากแชตบอต ทุกครั้งที่ระบบสรุปเอกสารหรืออ่านภาพ ล้วนเป็น AI Inference ทั้งสิ้น

  • AI Inference คืออะไร

    ช่วงที่โมเดลทำงานให้ผู้ใช้

    AI Inference คือการนำโมเดลที่ผ่านการ training แล้ว เช่น โมเดลภาษาขนาดใหญ่ (LLM) มารับคำถามและสร้างคำตอบ ส่วน training คือขั้นตอนสอนโมเดล ผู้ใช้จึงสัมผัส AI Inference โดยตรง และ AI Inference ต้องพร้อมให้บริการอยู่เสมอ

  • ทำไม AI Inference จึงสำคัญ

    ความเร็วและต้นทุนตัดสินกันตรงนี้

    ผู้ใช้ต้องรอคำตอบนานแค่ไหน ระบบรองรับคนพร้อมกันได้กี่คน และแต่ละคำตอบมีต้นทุนเท่าไร ทั้งหมดนี้ตัดสินกันที่ขั้นตอน AI Inference และขึ้นอยู่กับ hardware, engine และการตั้งค่าที่เลือกใช้

  • ทำไมต้องมีชุมชน

    เรียนรู้จากคนที่ลงมือทำ

    เครื่องมือด้าน AI Inference เปลี่ยนเร็ว และความรู้ที่ใช้ได้จริงมักมาจากคนที่ลองมาแล้ว Siam Inference เป็นพื้นที่ให้คนในประเทศไทยที่ทำงานด้าน AI Inference ได้แลกเปลี่ยนสิ่งที่ลอง สิ่งที่วัดได้ และสิ่งที่ได้เรียนรู้

สามหัวข้อที่ Siam Inference คุยกัน

Siam Inference คุยกันในสามหัวข้อ ตั้งแต่เครื่องที่รันโมเดล, software ที่ทำให้โมเดลตอบได้เร็ว ไปจนถึงคนที่ลงมือทำ

  1. Hardware

    ที่รันโมเดล

    Hardware คือเครื่องที่ใช้รันโมเดล AI ไม่ว่าจะเป็น GPU หรือ accelerator เฉพาะทาง จะตั้งอยู่ในองค์กร (on-premises) หรือบน cloud ก็ได้ แต่ละแบบมีข้อแลกเปลี่ยนเรื่องความเร็ว ราคา และการดูแลต่างกัน

    GPU และ Accelerator
    เลือกเครื่องให้เหมาะกับขนาดโมเดลและงบประมาณ
    ในองค์กรและ Cloud
    รันเองในองค์กร ใช้ cloud หรือผสมทั้งสองแบบ
  2. Inference Engine

    สิ่งที่ทำให้เร็ว

    Inference engine คือ software ที่โหลดโมเดลและให้บริการแก่ผู้ใช้ ตัวอย่างเช่น vLLM ส่วนเทคนิคอย่างการรวมคำขอเป็นชุด (batching) การย่อขนาดโมเดล (quantization) และการจัดการหน่วยความจำ ช่วยให้เครื่องเดิมตอบได้เร็วขึ้นและรองรับคนได้มากขึ้น

    LLM Serving
    ให้บริการโมเดลแก่ผู้ใช้หลายคนพร้อมกัน
    Quantization
    ย่อโมเดลให้ใช้หน่วยความจำน้อยลง
  3. ชุมชน

    คนที่ลงมือทำ

    ความรู้ด้าน AI Inference อยู่กับคนที่ลงมือทำจริง ทั้งการวัดผลให้เทียบกันได้ (benchmarking) การใช้โมเดลกับงานภาษาไทย และบทเรียนจากการนำระบบขึ้นใช้งานจริง

    Benchmarking
    วัดผลและบอกวิธีวัด เพื่อให้เทียบกันได้
    โมเดลภาษาไทย
    ประสบการณ์การใช้โมเดลกับงานภาษาไทย
อธิบายศัพท์เทคนิค
AI Inference
การนำโมเดลที่ผ่านการ training แล้วมาใช้สร้างคำตอบ
LLM (โมเดลภาษาขนาดใหญ่)
โมเดล AI ที่อ่านและเขียนข้อความ เช่น โมเดลที่อยู่เบื้องหลังแชตบอต
GPU / Accelerator
ชิปที่คำนวณงานของโมเดลได้เร็วกว่า CPU ทั่วไป
Inference Engine
Software ที่โหลดโมเดลและรับคำขอจากผู้ใช้ เช่น vLLM
Batching
การประมวลผลคำขอหลายรายการพร้อมกันในรอบเดียว
Quantization
การลดความละเอียดของตัวเลขในโมเดล เพื่อให้ใช้หน่วยความจำน้อยลง
TTFT (time to first token)
เวลาที่ผู้ใช้รอจนเห็นคำแรกของคำตอบ
Throughput
ปริมาณงานที่ระบบทำได้ในช่วงเวลาหนึ่ง
Benchmark
การวัดผลด้วยวิธีเดียวกัน เพื่อเปรียบเทียบระบบ

เว็บไซต์ในเครือข่าย Siam Inference

Siam Inference อยู่ในเครือข่ายเดียวกับเว็บไซต์เหล่านี้ แต่ละแห่งมีเนื้อหาและจุดเน้นของตัวเอง

ชุมชน

vLLM Bangkok

ชุมชนคนไทยด้าน vLLM ซึ่งเป็น open-source engine ที่ให้บริการโมเดลขนาดใหญ่ได้รวดเร็ว สำหรับคนที่สร้างระบบ AI Inference และโครงสร้างพื้นฐาน

บริษัท

AGICAFET

บริษัทในประเทศไทยที่วางระบบ AI ส่วนตัวให้ใช้งานได้ในที่ของคุณเอง ทั้ง Local AI ที่รันในสำนักงาน Hybrid AI ที่เสริมด้วย cloud เมื่อคุณต้องการ และ Physical AI ในเครื่องจักรและหุ่นยนต์

AGICAFET เป็นผู้จัด Siam Inference

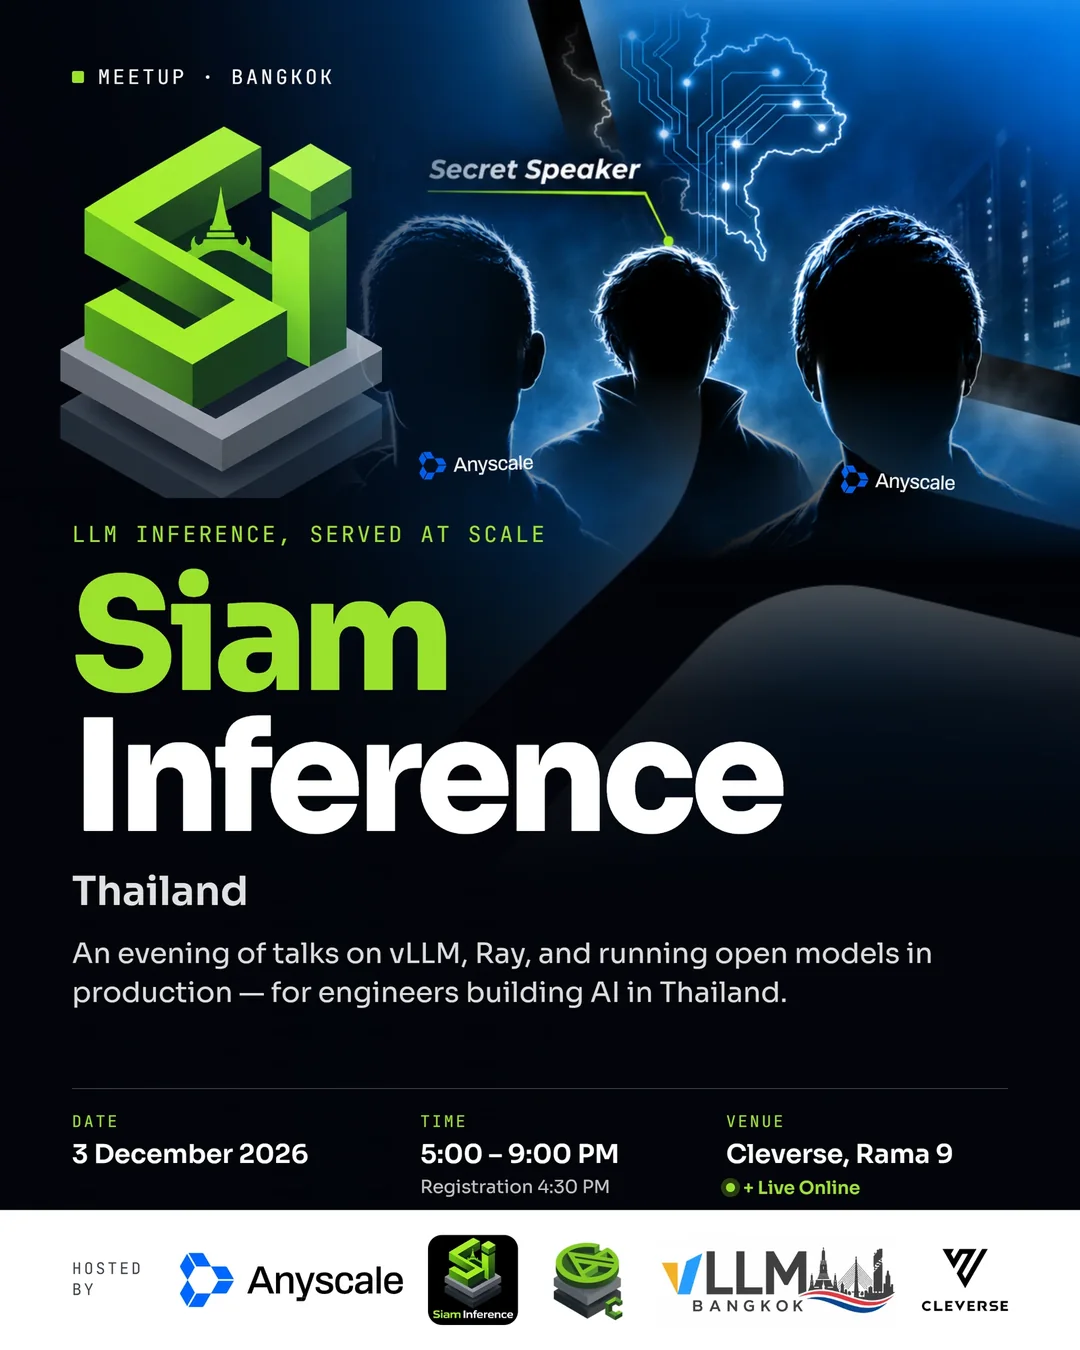
โปสเตอร์งาน Siam Inference Thailand: Meetup ที่ Bangkok วันที่ 3 ธันวาคม 2026 เวลา 17:00–21:00 น. ที่ Cleverse, Rama 9 และ Live Online ภาพเงาของวิทยากรสามคน หนึ่งคนมีป้าย Secret Speaker

เปิดลงทะเบียนแล้ว Meetup · Bangkok

Siam Inference Thailand

LLM Inference, served at scale

Meetup สำหรับคนทำ AI ที่อยากรู้ว่า LLM Inference ระดับ production ทำกันอย่างไร หนึ่งค่ำกับ talk เรื่อง vLLM, Ray และการรัน open model ใน production สำหรับ engineer ที่สร้าง AI ในประเทศไทย

ลงทะเบียนบน Luma (เปิดในแท็บใหม่)

ลงทะเบียนฟรีผ่าน Luma จากนั้นจะมีการคัดเลือกจากคำตอบในแบบฟอร์ม และผู้ที่ผ่านการคัดเลือกจะได้รับอีเมลยืนยัน

วันที่
วันพฤหัสบดีที่ 3 ธันวาคม 2026
เวลา
17:00–21:00 น.
ลงทะเบียนหน้างาน
ตั้งแต่ 16:30 น.
สถานที่
Cleverse, Rama 9
Live Online
เลือก Onsite หรือ Online ได้ตอนลงทะเบียน
Hosted by
Anyscale, Siam Inference, AGICAFET, vLLM Bangkok, Cleverse

ในงานมีอะไรบ้าง

  • Roadmap ของ AI Inference ในประเทศไทย
    Natdhanai Praneenatthavee · CEO, AGICAFET · Founder, Siam Inference
  • vLLM Inference in Depth
    Kanin Kearpimy · Co-founder, vLLM Bangkok
  • Ray: Distributed AI without the Distributed Headache
    Edward Oakes · Staff Software Engineer, Anyscale

    Pawarit Laosunthara (Jin) · Manager, Forward Deployed Engineering, Anyscale
  • Student Showcase
  • Secret Speaker
    ยังไม่เปิดเผยชื่อ
  • Networking ปิดท้ายงาน

และ session อื่นที่จะประกาศเพิ่มเติม

ผู้ที่ต้องการเสื้อ limited สั่งซื้อได้ในขั้นตอนลงทะเบียน

งานนี้เปิดรับ sponsor ที่อยากร่วมทำให้ประเทศไทยดีขึ้น ติดต่อ natdhanai.pra@agicafet.com

ลงทะเบียนบน Luma (เปิดในแท็บใหม่)

กิจกรรมที่ผ่านมา

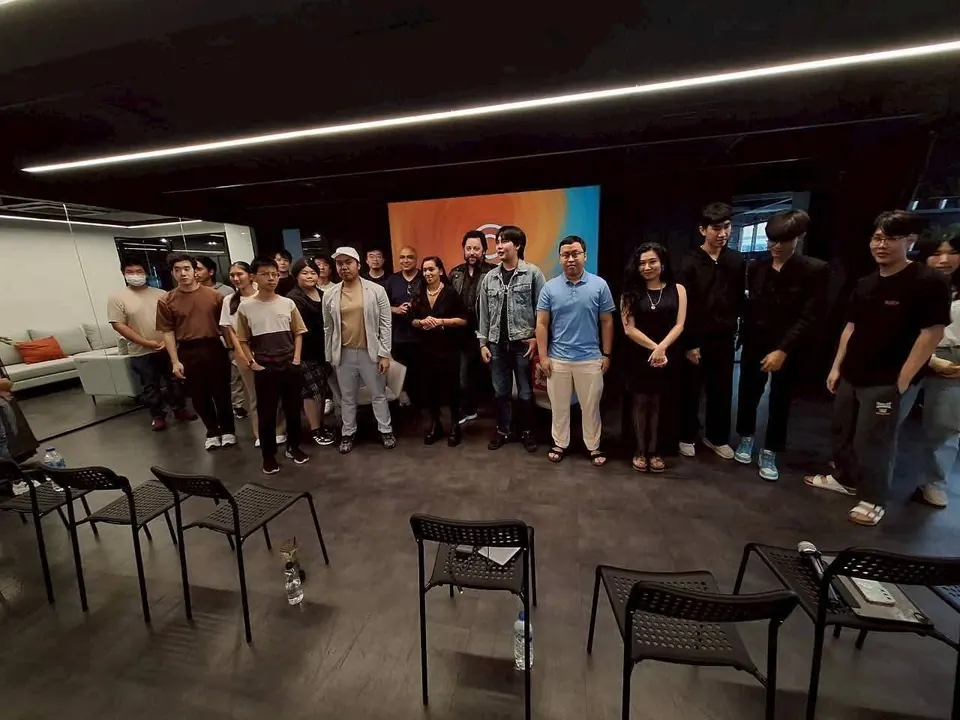
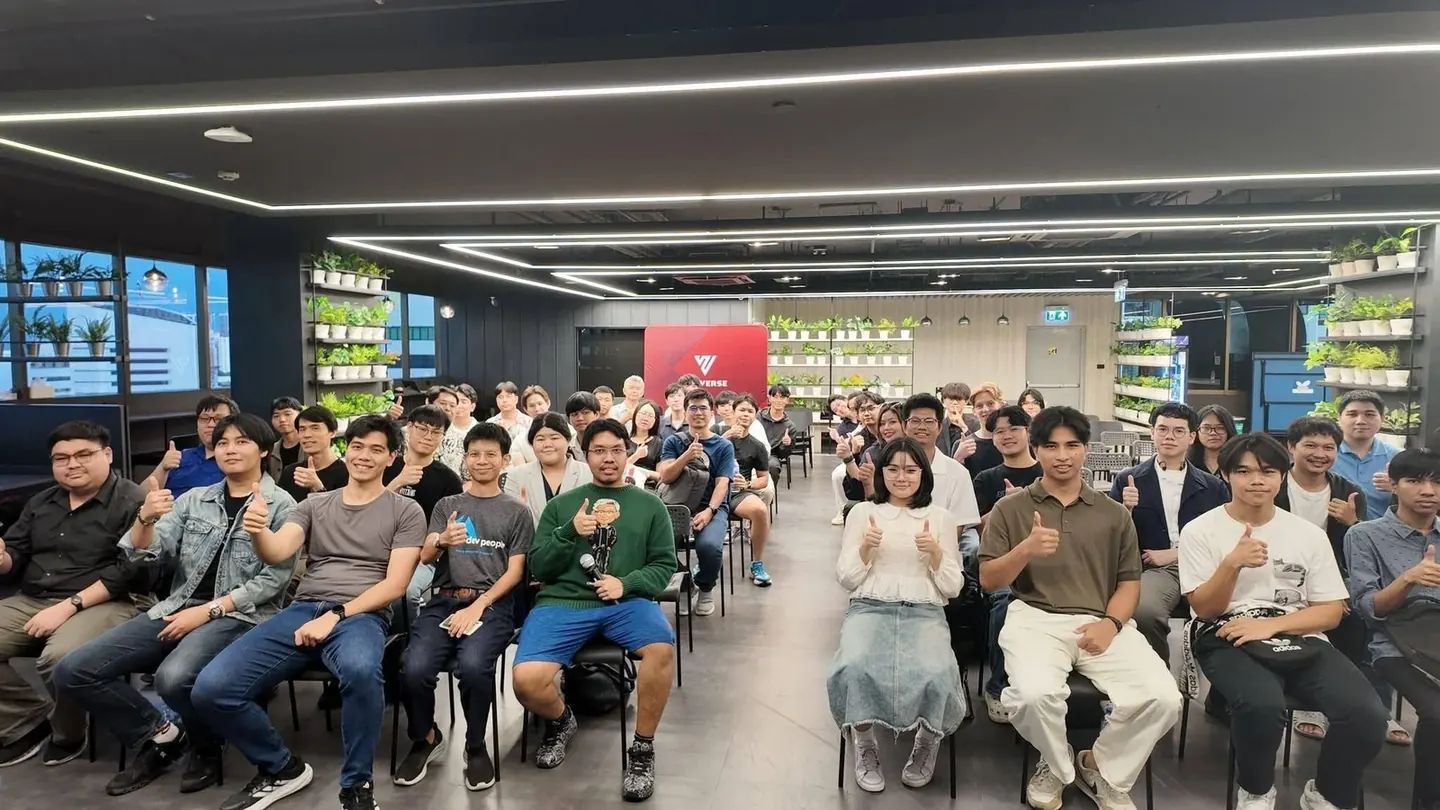
Siam Inference จัดกิจกรรมมาตั้งแต่ปี 2025 เริ่มจากงาน Maker to Maker ครั้งแรก
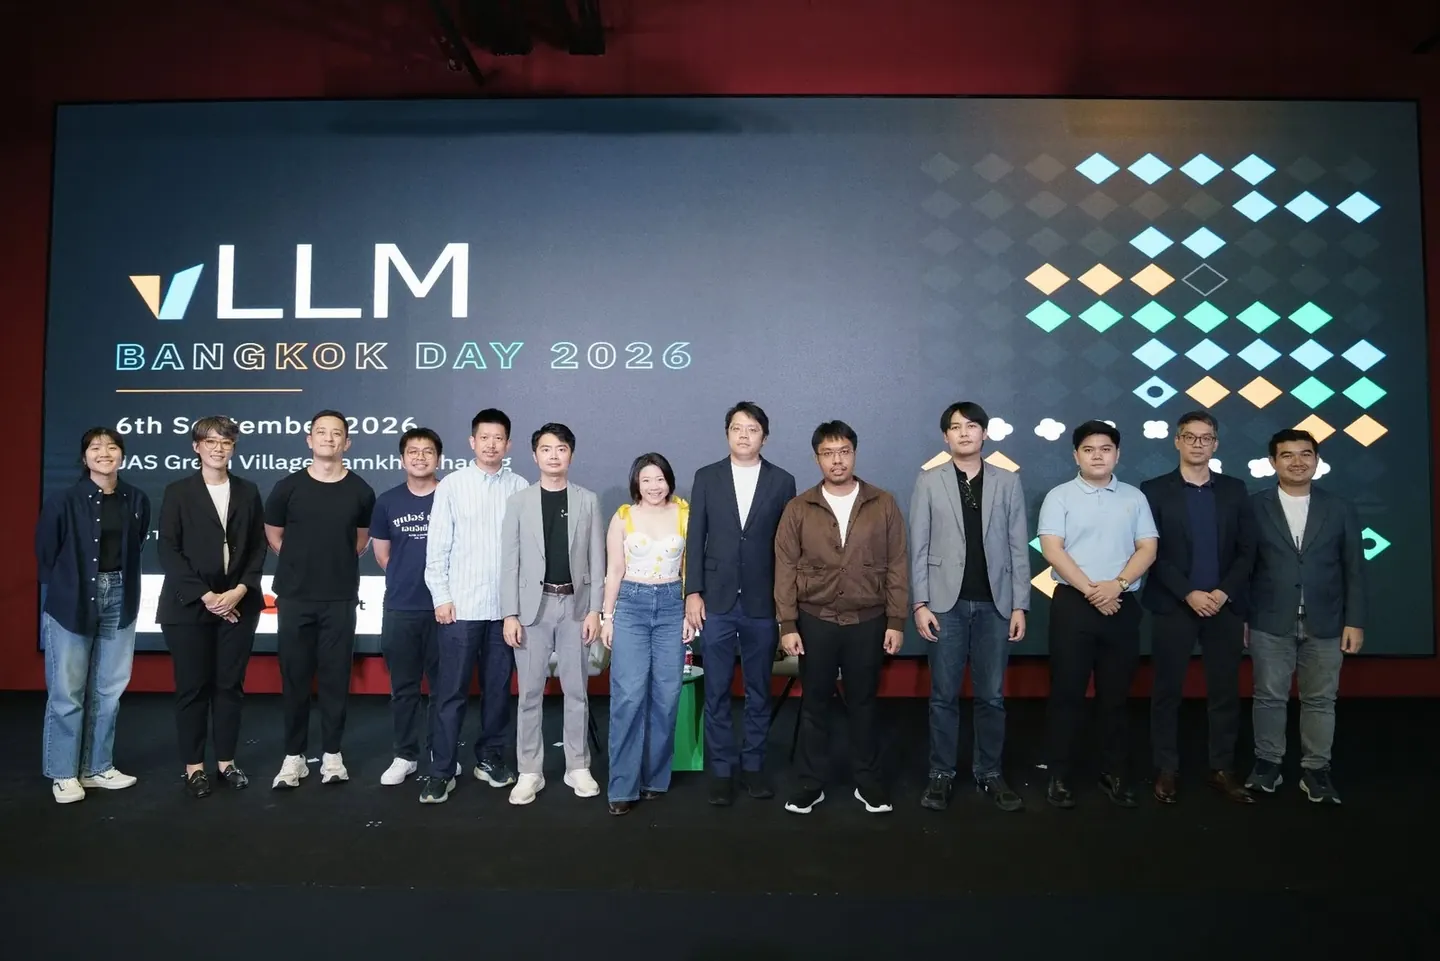
  • ผู้คนยืนเรียงกันบนเวที โดยมีจอด้านหลังเขียนว่า vLLM Bangkok Day 2026
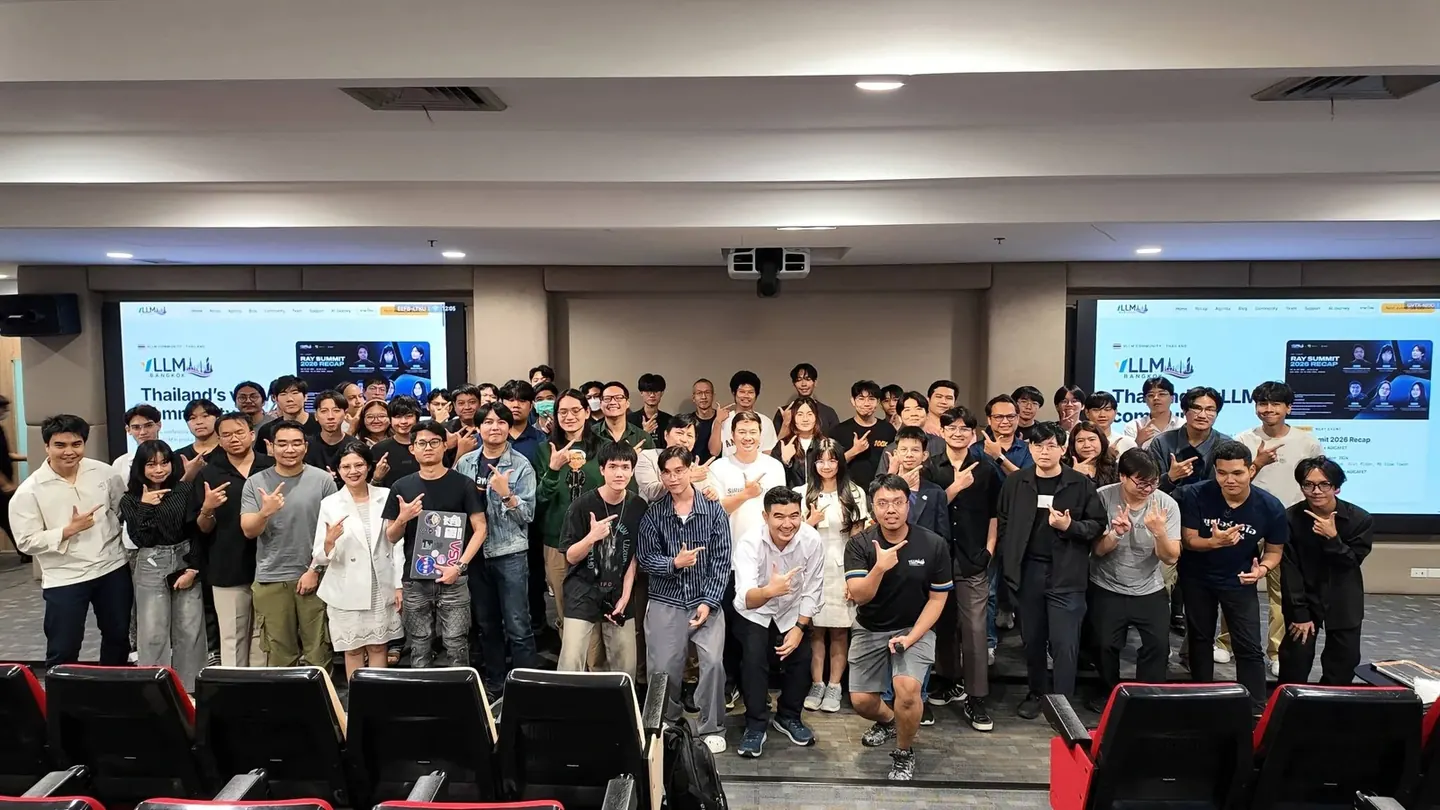
  • กลุ่มคนถ่ายรูปร่วมกันในห้องบรรยาย โดยมีจอด้านหลังเขียนว่า Ray Summit 2026 Recap
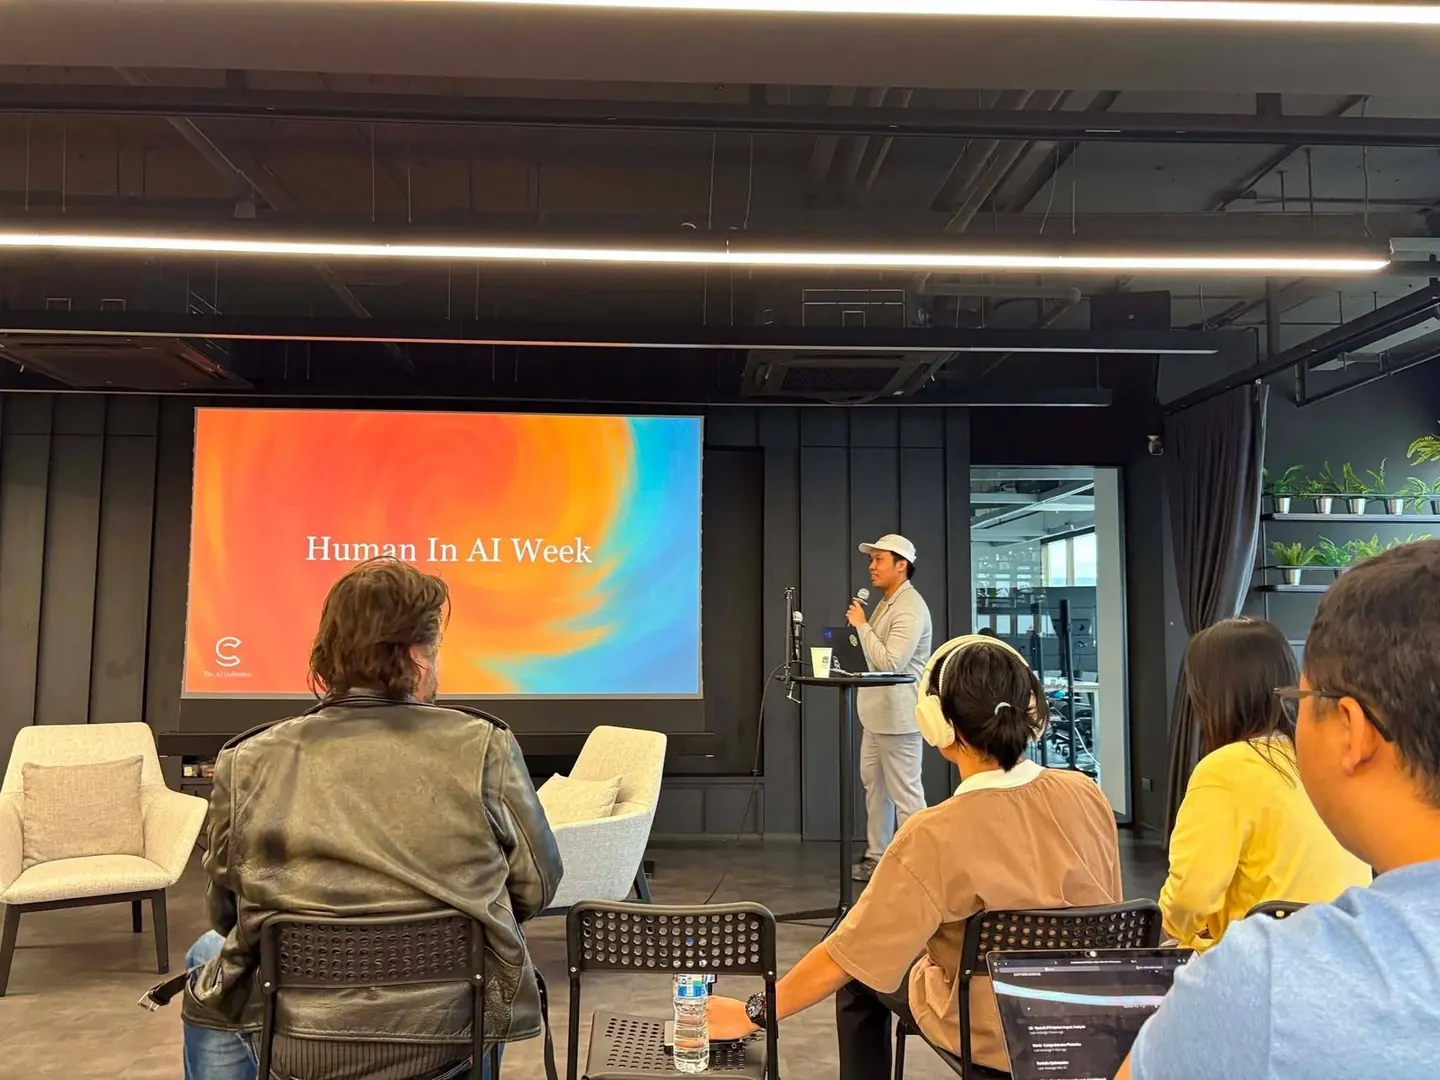
  • ผู้บรรยายพูดข้างจอที่เขียนว่า Human In AI Week มองจากที่นั่งผู้ฟัง
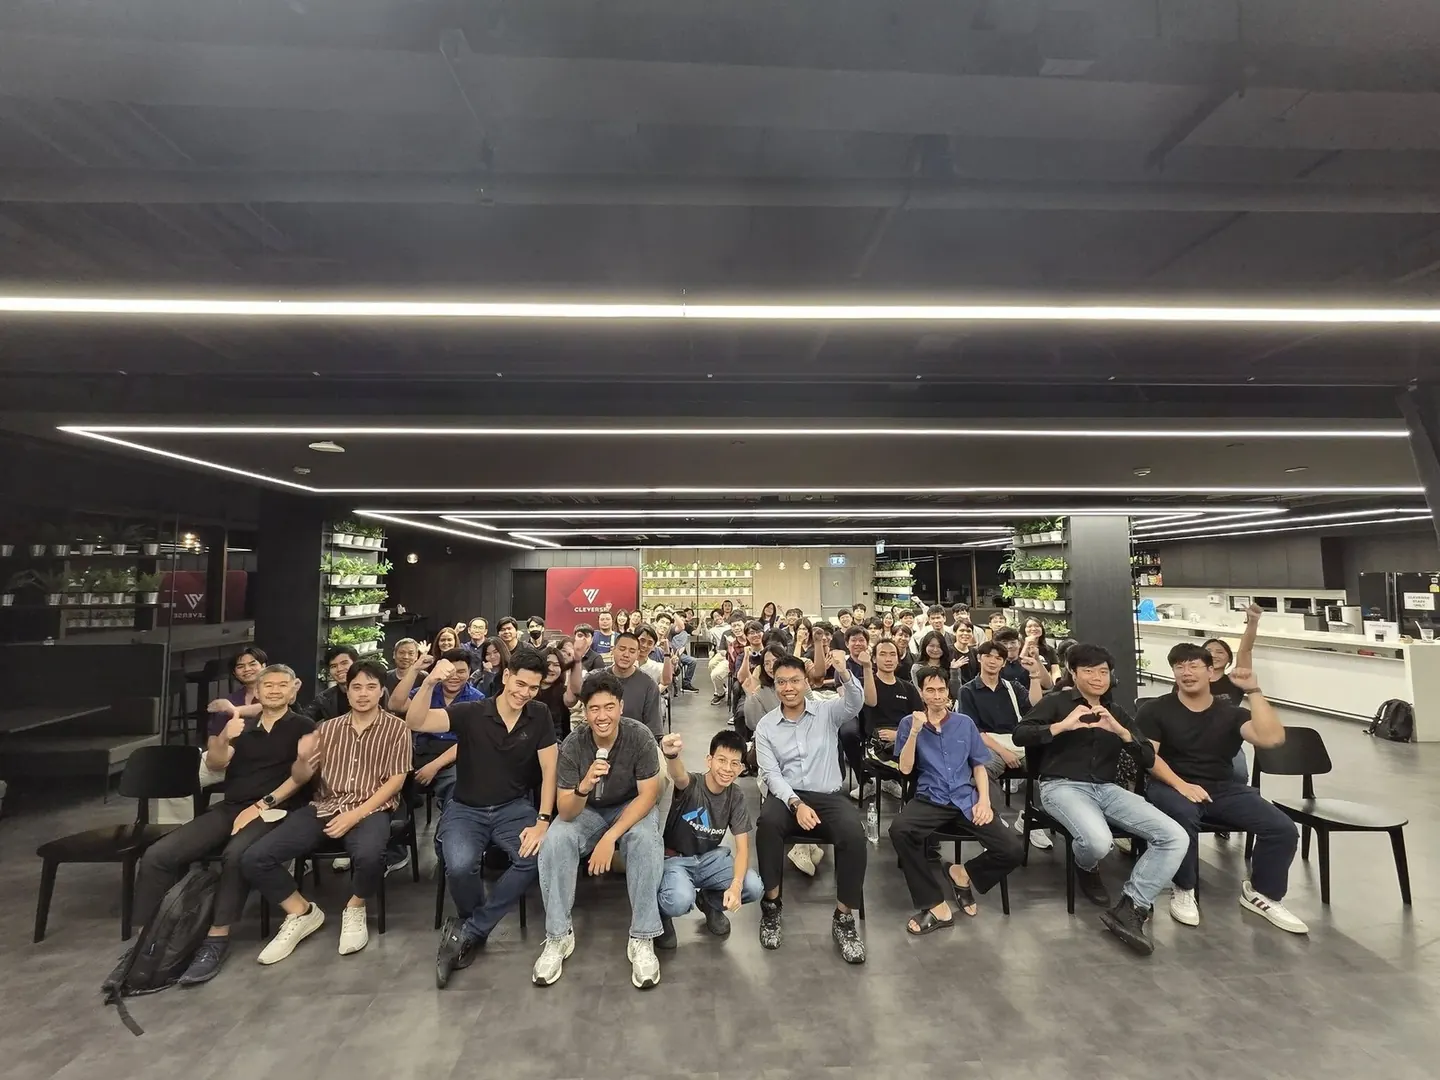
  • ผู้ฟังนั่งชูกำปั้นและยิ้มให้กล้อง
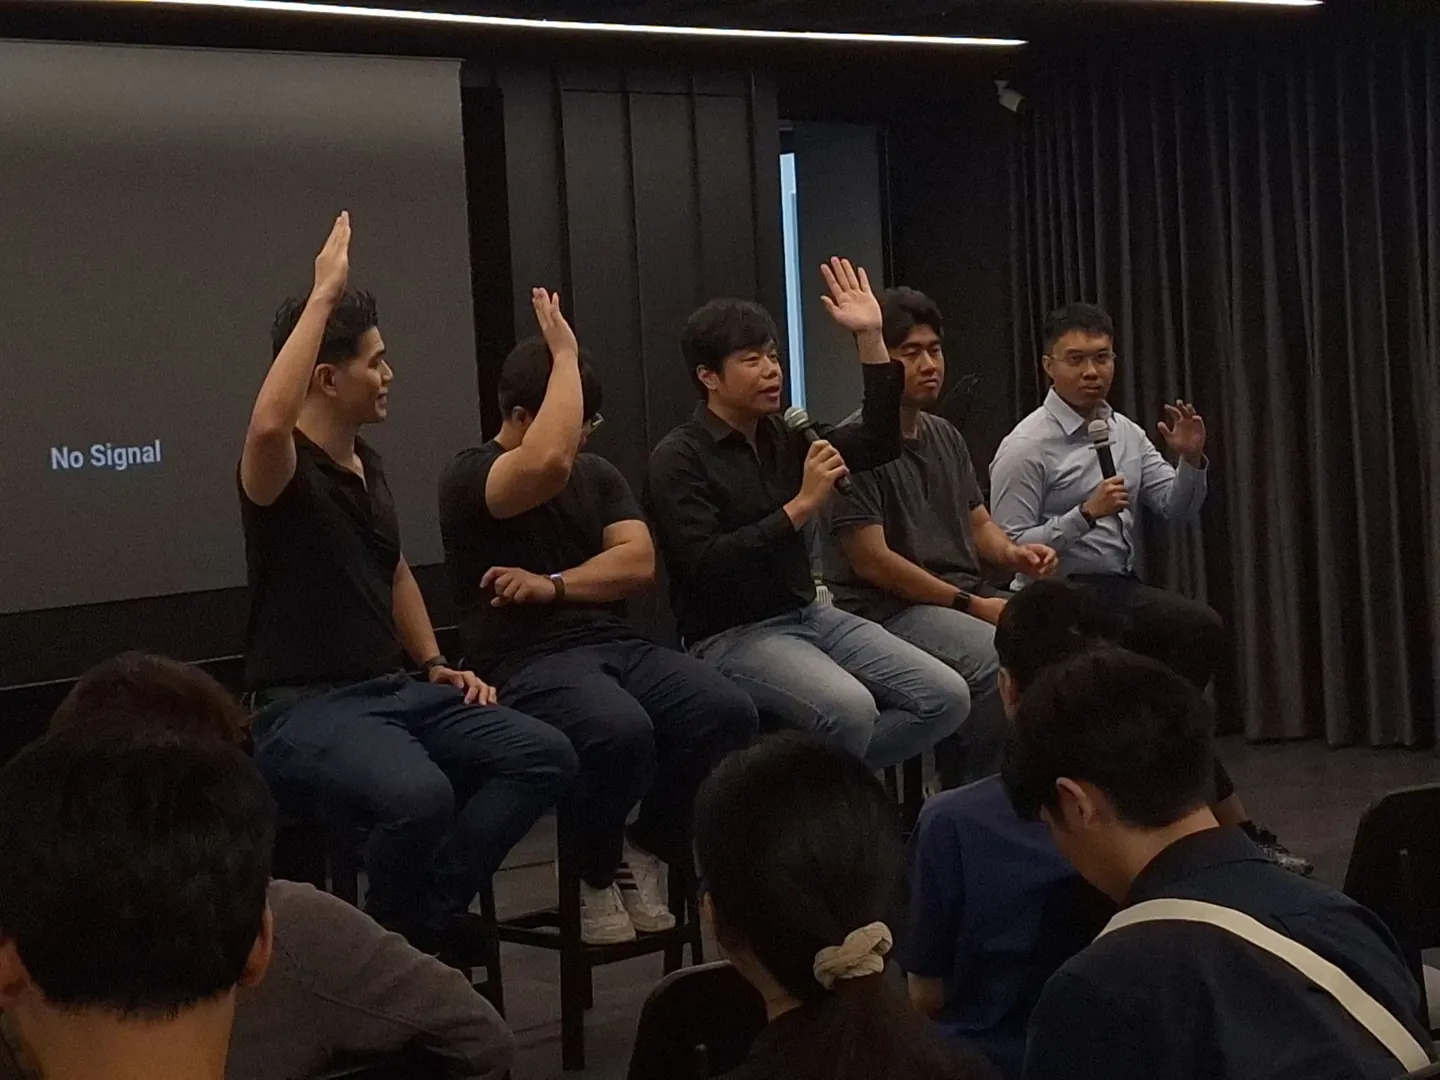
  • วิทยากรนั่งเสวนาหน้าผู้ฟัง บางคนยกมือ
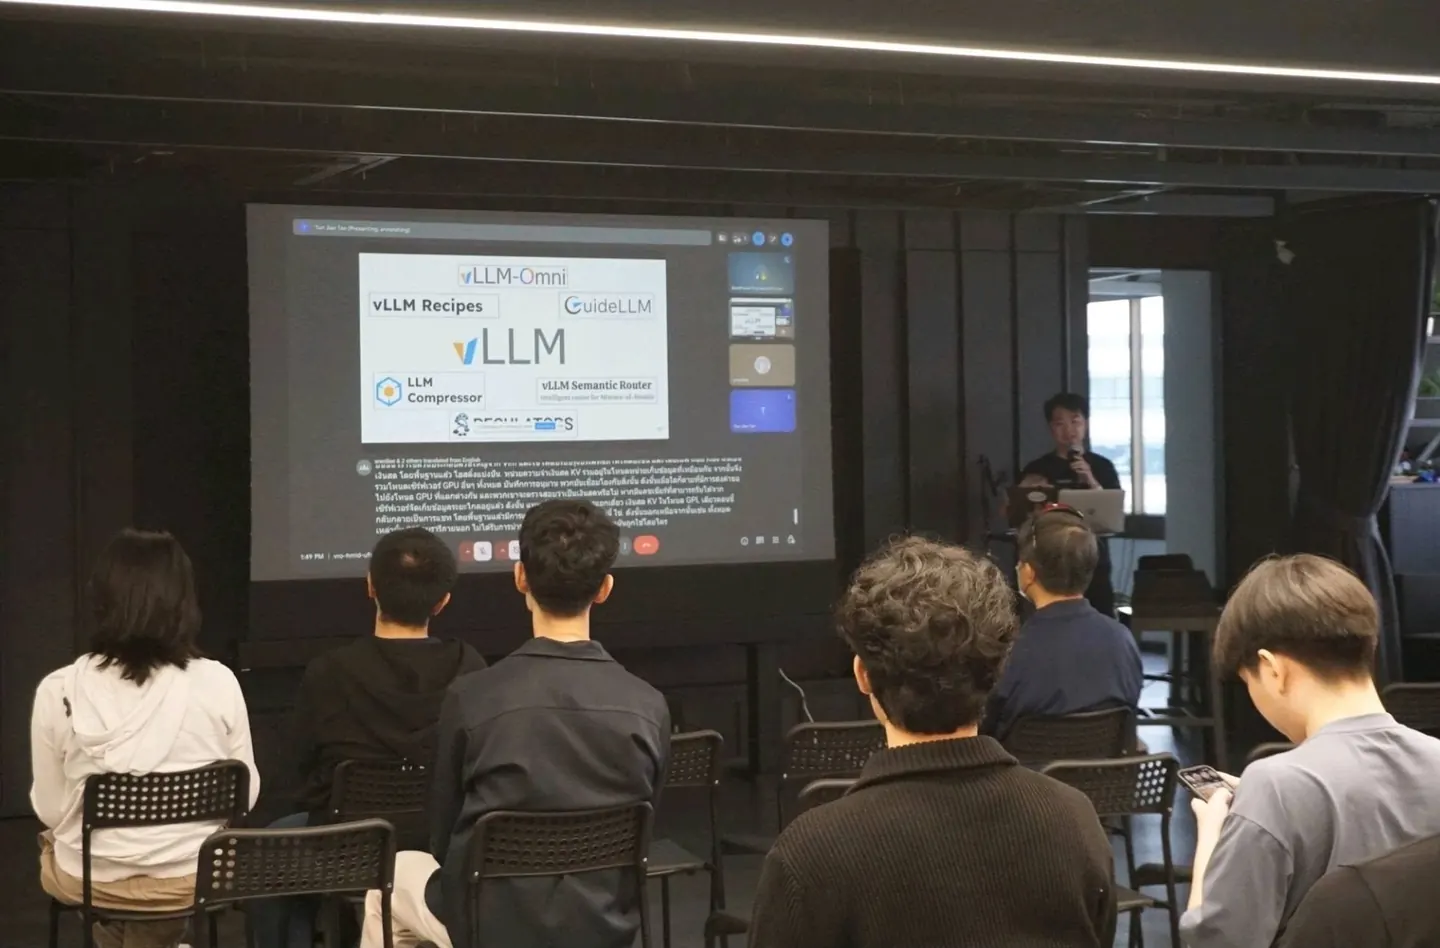
  • ผู้บรรยายข้างจอที่มีโลโก้โครงการของ vLLM และคำบรรยายภาษาไทย หน้าผู้ฟังที่นั่งฟัง
  • กลุ่มคนยืนหน้าจอที่มีลายวงก้นหอยสีส้มและฟ้า
  • ผู้ฟังนั่งชูนิ้วโป้งให้กล้อง

Open-Source Contributor

Natdhanai Praneenatthavee (GitHub: spped2000) ส่ง pull request เพื่อแก้ปัญหาใน repo open-source ของ NVIDIA ไป 9 รายการ ใน 6 repo merge แล้ว 5 รายการ อีก 4 รายการรอ review

สนใจเข้าร่วมชุมชน หรือเป็น Sponsor?

ติดต่อ: natdhanai.pra@agicafet.com

คำถามที่พบบ่อย

AI Inference คืออะไร
AI Inference (การอนุมาน) คือการนำโมเดล AI ที่ผ่านการ training แล้วมาใช้งานจริง เช่น ตอบคำถามในแชตบอต สรุปเอกสาร หรืออ่านภาพ ทุกครั้งที่มีคนใช้งานโมเดล นั่นคือ AI Inference
AI Inference ต่างจาก Training อย่างไร
AI Inference คือการนำโมเดลที่ผ่านการ training แล้วมาตอบคำขอใหม่โดยไม่ได้เรียนรู้เพิ่ม ส่วน training คือการสอนโมเดลด้วยข้อมูลจำนวนมากเพื่อปรับค่าภายในของโมเดล เวลาที่ผู้ใช้รอคำตอบและต้นทุนต่อคำตอบจึงขึ้นอยู่กับขั้นตอน AI Inference
รัน LLM บนเครื่องตัวเองได้ไหม
รัน LLM บนเครื่องตัวเองได้ ถ้าหน่วยความจำของเครื่อง โดยเฉพาะ VRAM ของการ์ดจอ เพียงพอสำหรับขนาดของโมเดล การทำ quantization ช่วยให้โมเดลใช้หน่วยความจำน้อยลง เครื่องมืออย่าง Ollama และ llama.cpp ใช้รันโมเดลบนเครื่องส่วนตัว ส่วน vLLM ออกแบบมาเพื่อให้บริการโมเดลแก่ผู้ใช้หลายคนพร้อมกัน
Siam Inference เหมาะกับใคร
Siam Inference เหมาะกับคนที่ทำงานหรือสนใจเรื่องการรันโมเดล AI ไม่ว่าจะเป็นวิศวกร นักพัฒนา นักวิจัย นักศึกษา หรือคนที่กำลังเลือกระบบให้องค์กร
เข้าร่วม Siam Inference ได้อย่างไร
กรอกใบสมัครที่ apply.siaminference.ai แล้วรอผลการพิจารณาทางอีเมล ส่วนเว็บไซต์ Siam Inference อ่านได้โดยไม่ต้องสมัครสมาชิก
Siam Inference เกี่ยวข้องกับ vLLM Bangkok, Cerebras Thailand และ AGICAFET อย่างไร
Siam Inference จัดโดย AGICAFET และอยู่ในเครือข่ายเดียวกับ vLLM Bangkok และ Cerebras Thailand โดยแต่ละแห่งมีเนื้อหาของตัวเอง vLLM Bangkok คือชุมชนคนไทยด้าน vLLM (vllmbangkok.com) Cerebras Thailand คือชุมชนผู้ใช้และนักพัฒนา Cerebras ในประเทศไทย (cerebras.siaminference.ai) และ AGICAFET คือบริษัทในประเทศไทยที่วางระบบ AI ส่วนตัว และเป็นเจ้าของผลิตภัณฑ์ PreMize (agicafet.com)
ติดตาม Siam Inference ได้ที่ไหน
ช่องทางของ Siam Inference จะเปิดเร็ว ๆ นี้ (Coming Soon) ระหว่างนี้ติดตามได้ที่เพจ Facebook ของ vLLM Bangkok (facebook.com/vllmbangkok) และ Cerebras Thailand (facebook.com/cerebrasthailand)

เข้าร่วม Siam Inference

Siam Inference เปิดรับสมัครเข้าร่วมชุมชนแล้ว เล่าว่าคุณทำอะไรอยู่ อยากมีส่วนร่วมด้านไหน และมองเรื่อง Local AI อย่างไร เมื่อพิจารณาแล้ว Siam Inference จะติดต่อกลับทางอีเมล
สมัครเข้าร่วม Siam Inference